پیشبینی کیفیت مبتنی بر الگوریتم میتواند نیاز به بخشی از آزمونهای فیزیکی مستمر را کاهش دهد، ضایعات مواد را کم کند و چرخه توسعه محصول را سرعت ببخشد.
در فرآوری پلیمرها، بسیاری از مشکلات کیفیت و پایداری فرایند از عواملی ناشی میشوند که همیشه بهصورت مستقیم قابل مشاهده نیستند. تغییر دمای مذاب، تنش برشی، رطوبت، زمان ماند و حتی تغییرات جزئی در مواد اولیه میتوانند ساختار پلیمر را تغییر داده و در نهایت بر خواصی مانند استحکام کششی، چقرمگی و وزن مولکولی اثر بگذارند.
مهندس فرایند معمولاً این تغییرات را از طریق تجربه، پایش پارامترهای دستگاه و انجام آزمونهای آزمایشگاهی شناسایی میکند. مسئله این است که بسیاری از این آزمونها زمانبر، پرهزینه یا مخرب هستند و ممکن است زمانی نتیجه را نشان دهند که محصول تولید شده باشد.
اینجاست که یادگیری ماشین میتواند بهعنوان یک ابزار مهندسی برای تحلیل دادههای فرایند وارد شود. هدف، جایگزین کردن مهندس یا حذف آزمونهای ضروری نیست؛ بلکه استفاده از دادههای موجود برای شناسایی روابطی است که با روشهای معمول بهسادگی قابل مشاهده نیستند. مدلهای یادگیری ماشین میتوانند ارتباط میان پارامترهای فرایند، ویژگیهای مواد اولیه و خواص نهایی محصول را از روی دادههای قبلی یاد بگیرند و سپس از این روابط برای پیشبینی رفتار مواد یا تشخیص انحرافات فرایند استفاده کنند.
در این رویکرد، الگوریتمها در واقع یک لایه تحلیلی روی دادههای فرایند ایجاد میکنند. برخی روشها مشخص میکنند کدام متغیرها بیشترین اهمیت را دارند، برخی برای پیشبینی خواص ماده به کار میروند و برخی دیگر میتوانند محصولات یا شرایط فرایندی را در گروههای مختلف طبقهبندی کنند. در مراحل پیشرفتهتر نیز میتوان از این مدلها برای یافتن ترکیب مناسبی از پارامترهای تولید استفاده کرد.
بنابراین، اصطلاحاتی مانند انتخاب ویژگی، رگرسیون، ماشین بردار پشتیبان، شبکه عصبی یا الگوریتم ژنتیک که در ادامه مقاله با آنها روبهرو میشویم، موضوع اصلی مقاله نیستند. موضوع اصلی، یک مسئله مهندسی است: چگونه میتوان از دادههای فرایند و ابزارهای یادگیری ماشین برای شناخت بهتر تخریب پلیمر، پیشبینی خواص و در نهایت کنترل و بهینهسازی تولید استفاده کرد؟
برای درک بهتر این رویکرد، ابتدا به یکی از چالشهای مهم در فرآوری پلیمرها، یعنی تخریب ترمومکانیکی و هیدرولیتی، و نحوه استفاده از دادههای فرایند برای شناسایی و پیشبینی آن میپردازیم.
از دادههای فرایند تا پیشبینی تخریب پلیمر
تولیدکنندگان در فرآوری تجاری پلیمرها همواره با تخریب حرارتی، مکانیکی و هیدرولیتی مواجه هستند. گرما و تنش برشی میتوانند موجب گسست زنجیرههای پلیمری شوند، وزن مولکولی را کاهش دهند و در نتیجه خواصی مانند تنش تسلیم را تغییر دهند.
بهجای آنکه خطوط اکستروژن صنعتی را جعبههای سیاه در نظر بگیریم، میتوان از دادههای حاصل از فرایند که بوسیله تجهیزاتی مانند حسگر ها بدست می آید و ابزارهای تحلیلی برای شناسایی تغییرات ساختاری پلیمر استفاده کرد. در یکی از رویکردهای مورد بررسی، طیفسنجی مادون قرمز نزدیک (Near-Infrared Spectroscopy یا NIR) در کنار روش انتخاب ویژگی به روش حذف بازگشتی (Recursive Feature Elimination یا RFE) برای پایش تغییرات ساختاری به کار گرفته شده است.
در این رویکرد، انتخاب ویژگی به شناسایی متغیرها و شاخصهایی کمک میکند که بیشترین ارتباط را با افت کیفیت دارند. عدد موجهای مشخص در طیف NIR میتوانند تغییرات ظریف مرتبط با ارتعاشات خمشی و کششی را آشکار کرده و تغییرات زنجیرههای پلیلاکتیک اسید (PLA) را در طول فرایند پایش کنند.
هنگامی که PLA حساس به رطوبت با گرید پزشکی در محیط نیتروژن فرآوری میشود، کنترل دقیق فرایند برای دستیابی به عملکرد مناسب و جذب زیستی مورد انتظار در داربستهای بافتی اهمیت زیادی دارد. در مقابل، هنگام تولید PLA با گرید بستهبندی در شرایط محیطی، مدلهای تحلیلی میتوانند نشان دهند که چگونه افزایش دمای مذاب در خروجی دای اکسترودر با کاهش استحکام محصول ارتباط دارد.
این نوع تحلیل، دادههای قابل استفاده برای تصمیمگیری را در اختیار تیم تولید قرار میدهد و میتواند به اپراتورها کمک کند پیش از آنکه محصول خارج از محدوده مشخصات فنی تولید شود، شرایط فرایند و نواحی مختلف گرمایش را تنظیم کنند.
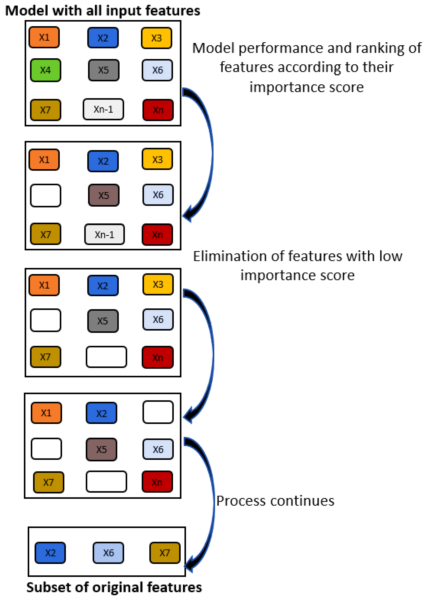
نمایش شماتیک فرایند انتخاب ویژگی به روش حذف بازگشتی (RFE).
چقدر میتوان به پیشبینی مدلهای یادگیری ماشین اعتماد کرد؟
استفاده از مدل پیشبینانه زمانی برای تولید ارزشمند است که عملکرد آن در برابر نتایج واقعی فرایند و آزمونهای فیزیکی ارزیابی شود. به همین دلیل، مهندسان خروجی مدلهای دیجیتال را با دادههای واقعی مقایسه میکنند و از شاخصهای آماری مختلف برای سنجش عملکرد مدل استفاده میکنند.
ضریب تعیین (R²) یکی از شاخصهای رایج برای ارزیابی میزان تغییرات توضیحدادهشده توسط مدل است. برای مثال، R² برابر با 96 درصد نشان میدهد که مدل توانسته است بخش عمدهای از تغییرات مشاهدهشده در دادههای واقعی را توضیح دهد. بااینحال، R² بهتنهایی برای ارزیابی یک مدل کافی نیست.
برای اندازهگیری میزان خطای پیشبینی، شاخصهایی مانند RMSE و MAPE نیز مورد استفاده قرار میگیرند. در این شاخصها معمولاً مقادیر کمتر نشاندهنده خطای پیشبینی پایینتر هستند. برای مسائل طبقهبندی نیز میتوان از شاخصهایی مانند AUC استفاده کرد تا توانایی مدل در تفکیک محصولات یا شرایط قابلقبول از موارد نامطلوب ارزیابی شود.
دادههای مقاله نشان میدهند که عملکرد مدلها به نوع فرایند، ماده و ویژگی مورد پیشبینی وابسته است:
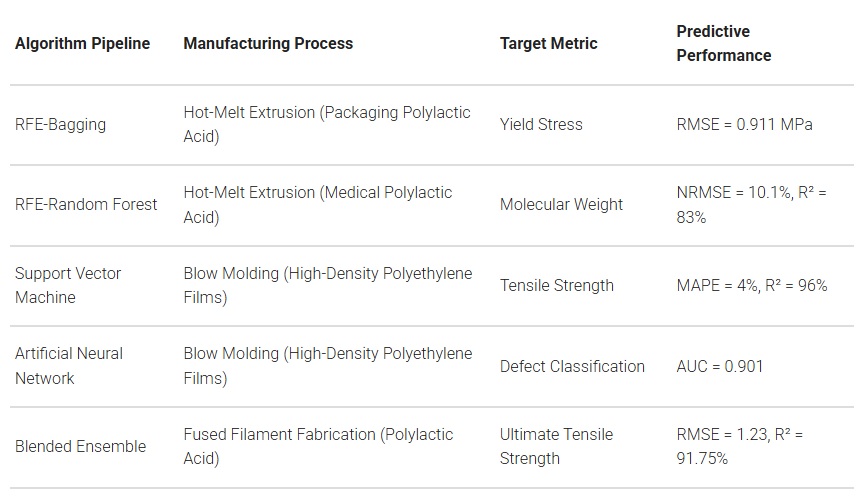
مقایسه عملکرد مدلهای یادگیری ماشین در فرایندهای مختلف تولید محصولات پلیمری.
این دادهها نشان میدهند که انتخاب مناسب متغیرهای ورودی و استفاده از مدلهای یادگیری ماشین میتواند در برخی مسائل عملکرد مناسبی در پیشبینی و طبقهبندی ایجاد کند. برای مثال، استفاده از ماشین بردار پشتیبان (Support Vector Machine یا SVM) امکان طبقهبندی سریع عیوب در فیلمهای پلیاتیلن سنگین (HDPE) حاوی پرکننده کربنات کلسیم را فراهم کرده است.
همچنین، مدلهای شبکه عصبی میتوانند برای پیشبینی و طبقهبندی کیفیت فیلمهای تولیدشده مورد استفاده قرار گیرند. چنین مدلهایی در صورت آموزش و اعتبارسنجی مناسب میتوانند بخشی از نیاز به آزمونهای مخرب مستمر را کاهش داده و امکان پایش و راستیآزمایی دیجیتال کیفیت را فراهم کنند.
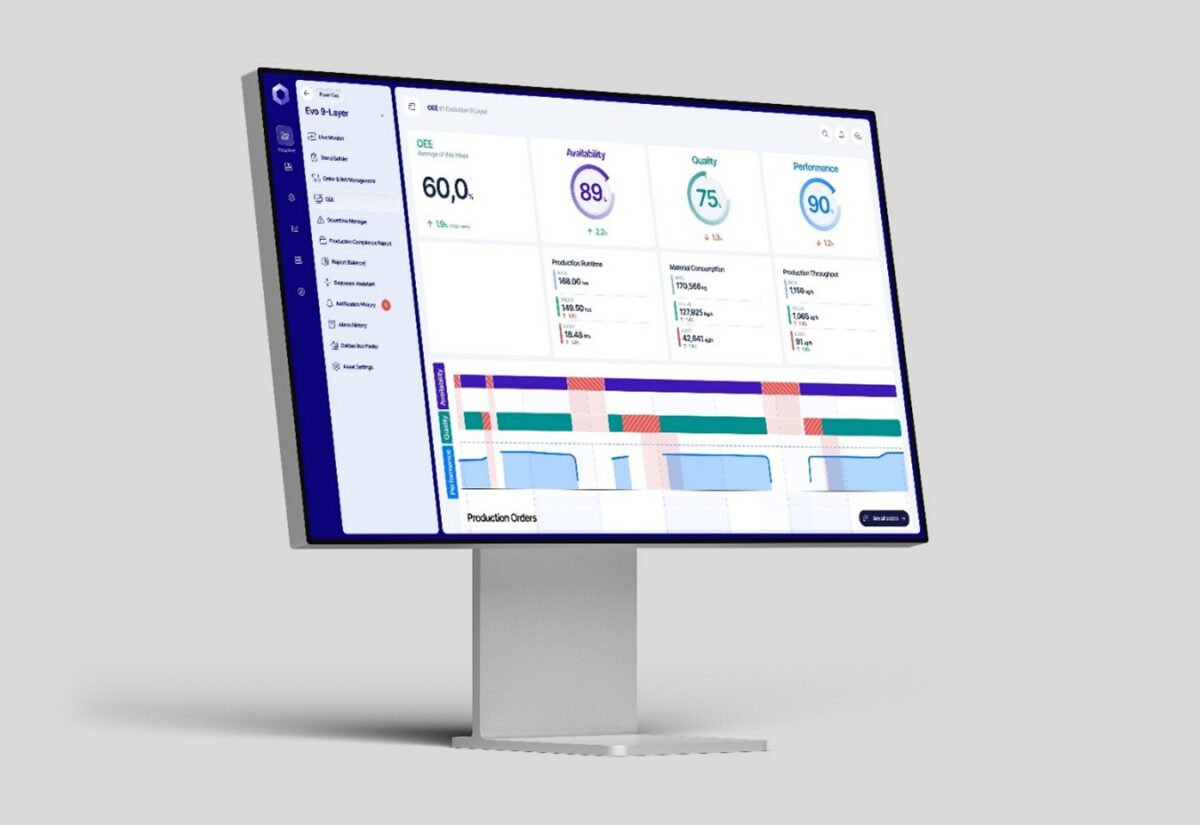
در یک سیستم صنعتی واقعی، ارزش این مدلها زمانی بیشتر میشود که خروجی آنها در کنار دادههای عملیاتی و شاخصهای تولید قرار گیرد. برای نمونه، ترکیب مدلهای پیشبینانه با داشبورد هوشمند تولید میتواند مسیر تبدیل دادههای خام فرایند به اطلاعات قابل استفاده برای تصمیمگیری را کوتاهتر کند.
بهینهسازی کامپوزیتهای پیشرفته در چاپ سهبعدی
کاربرد یادگیری ماشین تنها به اکستروژن متداول محدود نمیشود. پژوهشگران از روشهای تحلیلی و بهینهسازی الگوریتمی در فرآیند ساخت رشتهای ذوبشده (Fused Filament Fabrication یا FFF) نیز استفاده میکنند.
افزودن الیاف کربن به پلیلاکتیک اسید (PLA) میتواند استحکام کششی نهایی، سختی سازهای و رسانایی حرارتی را افزایش دهد. بااینحال، این تقویتکننده میتواند به کاهش چقرمگی و شکلپذیری کامپوزیت نیز منجر شود. بنابراین، مسئله اصلی تنها افزایش یک ویژگی نیست؛ بلکه یافتن نقطه تعادل میان چند ویژگی متعارض است.
برای ایجاد این تعادل، مهندسان از روشهای یادگیری تجمعی (Ensemble Learning) استفاده میکنند. این رویکرد با ترکیب چند مدل پایه، میتواند عملکرد پیشبینی را نسبت به استفاده از یک مدل منفرد بهبود دهد. در این حوزه، روشهایی مانند Gradient Boosting و مدلهای مبتنی بر درخت تصمیم از جمله رویکردهای مورد استفاده هستند.
علاوه بر این، الگوریتمهای ژنتیک (Genetic Algorithms) میتوانند برای جستوجو در فضای گستردهای از پارامترهای تولید مورد استفاده قرار گیرند. در کاربردهای FFF، چنین رویکردی میتواند به بررسی ترکیبهای مختلفی از پارامترهایی مانند ضخامت لایه، سرعت چاپ و دمای اکستروژن کمک کند تا ترکیب مناسب برای دستیابی به عملکرد مکانیکی موردنظر پیدا شود.
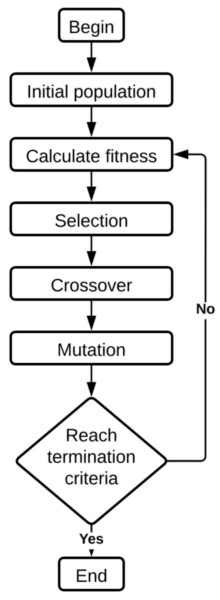
نمودار جریان الگوریتم ژنتیک برای بهینهسازی پارامترهای فرایند.
از مدل پیشبینانه تا تصمیمگیری در تولید
نکته مهم در استفاده صنعتی از یادگیری ماشین این است که مدل بهتنهایی هدف نهایی نیست. ارزش واقعی زمانی ایجاد میشود که خروجی مدل بتواند به یک تصمیم مهندسی یا عملیاتی منجر شود؛ برای مثال، شناسایی شرایطی که احتمال تخریب پلیمر را افزایش میدهند، پیشبینی یک ویژگی قبل از انجام آزمون، یا پیشنهاد محدوده مناسب برای پارامترهای فرایند.
در چنین ساختاری، مدل یادگیری ماشین میتواند بهعنوان یک لایه تحلیلی در کنار سیستمهای جمعآوری داده، داشبوردهای تولید و ابزارهای کنترل کیفیت قرار گیرد. این رویکرد امکان حرکت از «اندازهگیری پس از تولید» به سمت «پیشبینی پیش از ایجاد مشکل» را فراهم میکند.
وقتی بحث پیشبینی خواص در چنین ساختاری مطرح میشود، ابزارهای مدلسازی میتوانند بهعنوان بخشی از این لایه تحلیلی مورد استفاده قرار گیرند. برای نمونه، ابزار پیشبینی خواص پلیمر میتواند نمونهای از کاربرد مدلهای دادهمحور برای برآورد خواص و پشتیبانی از تصمیمگیری مهندسی باشد.
در بخشهایی که مدلهای یادگیری ماشین، انتخاب الگوریتم، آمادهسازی داده و کاربرد AI در صنعت پلیمر مطرح میشوند، یادگیری این مفاهیم نیز بخشی از مسیر پیادهسازی صنعتی است. برای آشنایی بیشتر با این موضوعات میتوانید از مرکز آموزش Polymer-IQ استفاده کنید.
برای شرکتهایی که قصد دارند چنین قابلیتهایی را بهصورت واقعی در فرایندهای تولیدی خود پیاده کنند، مسئله فقط انتخاب یک الگوریتم نیست؛ بلکه باید دادههای مناسب، متغیرهای مؤثر، روش اعتبارسنجی، زیرساخت داده و نحوه اتصال مدل به فرایند تولید نیز مشخص شود. این موضوع میتواند بخشی از یک پروژه مشاوره هوشمندسازی و تحول دیجیتال باشد.
در نهایت، یادگیری ماشین میتواند شیوه پایش و کنترل کیفیت در صنعت پلاستیک را بهبود دهد. مدلهای قابل تفسیر این امکان را فراهم میکنند که تیمهای تولید فقط یک عدد پیشبینیشده دریافت نکنند، بلکه بتوانند عوامل مؤثر بر تغییرات کیفیت و تخریب ترمومکانیکی را نیز بهتر درک کنند.
با ادغام نرمافزارهای پیشبینانه با تجهیزات اکستروژن و سایر فرایندهای تولید، تولیدکنندگان میتوانند به سمت کاهش ضایعات مواد، کوتاهتر شدن چرخه توسعه محصول و افزایش یکنواختی خواص مکانیکی حرکت کنند.
جمعبندی
تجربههای مورد بررسی در این مقاله نشان میدهند که یادگیری ماشین میتواند دادههای فرایند را به ابزاری برای شناخت بهتر رفتار پلیمر تبدیل کند. از پایش تخریب PLA در اکستروژن و پیشبینی خواص فیلمهای پلیمری گرفته تا بهینهسازی پارامترهای چاپ سهبعدی، کاربرد اصلی این فناوری نه در نام الگوریتمها، بلکه در حل مسائل مشخص مهندسی و تولید است.
منبع: Andres Delgado، «AI Models Predict Polymer Degradation During Extrusion»، Plastics Engineering، July 14, 2026.